문제 상황 pytorch에서 텐서 연산 시 빠른 처리를 위해 batch로 연산하는 경우가 많다. 그런데 하나씩 하나씩 연산하는 것과, 배치로 한꺼번에 연산하면 결과값이 미세하게 달라지는 현상을 발견했다. 다음은 전체 코드이다. 코드 import torch from torch.nn import Linear, Module class NN(Module): def __init__(self): super().__init__() self.fc1 = Linear(64, 2) def forward(self, x): x = self.fc1(x) return x def main(): batch_size = 10 x = torch.rand((batch_size, 64)) nn = NN() # one by one l = []..
구매하기까지 써본 헤드폰으로는 크리에이티브 오르바나 라이브 베이어다이나믹 DT770 pro 32옴 Koss KSC75 로 그렇게 많지 않다. 연구실에서 쓸 거라서 패시브 노이즈캔슬링이 필요했고 그래서 밀폐형 중에 열심히 알아봤다. HD569, K371과 고민하다가 K361로 결정했다. HD569는 호불호가 많이 갈리는 소리라는 리뷰가 꽤 많았고, K371보다도 K361이 더 괜찮았다는 리뷰가 있어서,,, 그리고 5만원정도 더 싸서 고르게 되었다. K361은 블루투스 모델과 유선 모델이 있는데 이것도 5만원정도 싸고 유선모델이 가벼우니까 착용감이 더 좋을 거라고 생각해서 유선으로 골랐다. 블루투스 모델이었으면 배터리에 조금이라도 신경을 써야 한다는 점이 거슬릴 것 같아서 유선이 오히려 좋았다. 소리 해상력..
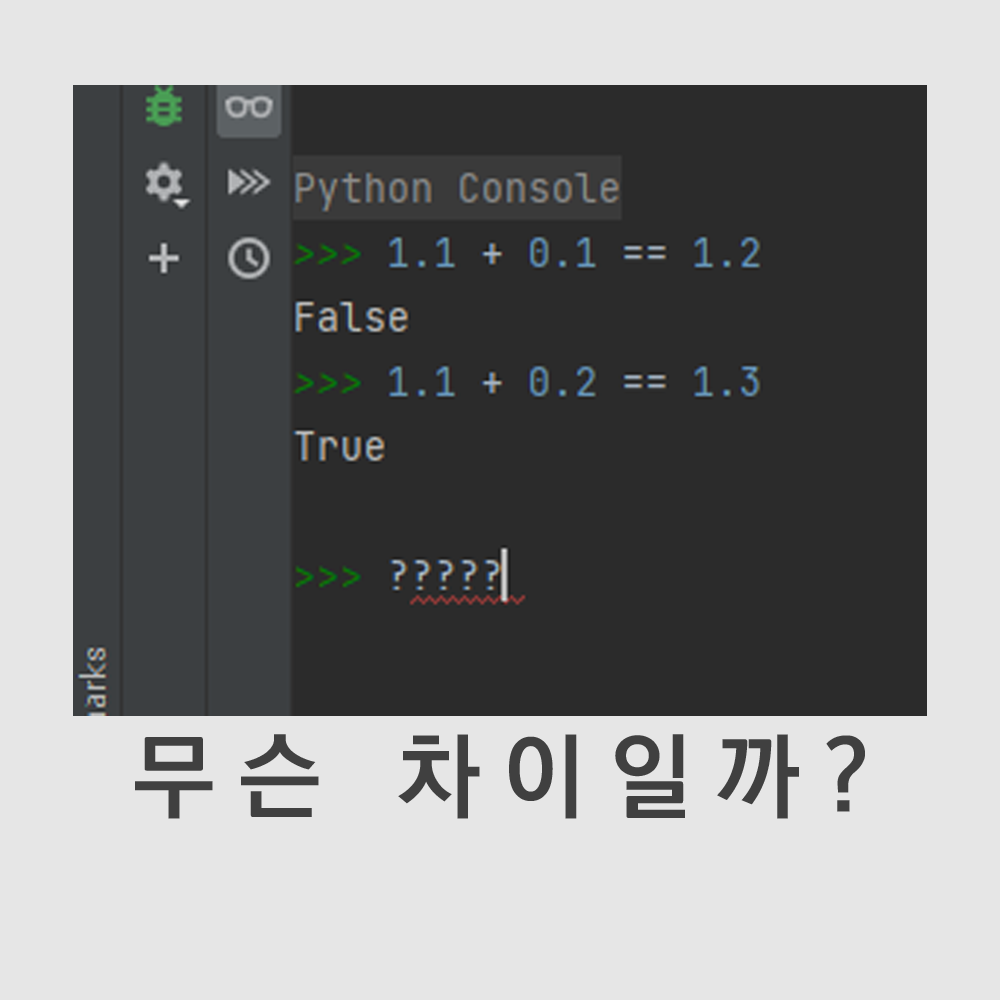
1.1+0.1과 1.1+0.2의 차이 사진은 파이썬 콘솔에서 실행한 모습이지만, 파이썬이 아닌 대부분의 프로그래밍 언어에서 비슷한 결과를 보인다. 이 문제의 원인은 컴퓨터 프로그래밍을 맨 처음 배울 때 알게 될 정도로 많은 사람들이 알고 있을 것이다. 원인은 컴퓨터가 소수를 저장하는 방식에 있다. 컴퓨터는 이진수의 부동소수점 방식으로 소수를 저장하기 때문에 우리가 쓰는 십진수 소수를 모두 정확히 표시할 수 없고, 어떤 값들은 근삿값으로 저장할 수밖에 없다. 하지만 사진처럼 어떤 연산은 정확히 나오고, 어떤 연산은 기대하지 않은 결과를 출력하는 모습을 보인다. 그래서 1.1+0.1==1.2은 False이고, 1.1+0.2==1.3은 True가 나오는 과정을 컴퓨터처럼 비트 단위로 계산해보면서 원인을 알아보..
문제 수빈이는 TV를 보고 있다. 수빈이는 채널을 돌리려고 했지만, 버튼을 너무 세게 누르는 바람에, 일부 숫자 버튼이 고장났다. 리모컨에는 버튼이 0부터 9까지 숫자, +와 -가 있다. +를 누르면 현재 보고있는 채널에서 +1된 채널로 이동하고, -를 누르면 -1된 채널로 이동한다. 채널 0에서 -를 누른 경우에는 채널이 변하지 않고, 채널은 무한대 만큼 있다. 수빈이가 지금 이동하려고 하는 채널은 N이다. 어떤 버튼이 고장났는지 주어졌을 때, 채널 N으로 이동하기 위해서 버튼을 최소 몇 번 눌러야하는지 구하는 프로그램을 작성하시오. 수빈이가 지금 보고 있는 채널은 100번이다. 아이디어 주어진 리모컨 버튼(+, - 제외)으로 목표하는 채널 L과 가장 가까운 숫자 E로 가야 한다. 목표하는 채널의 자릿..
계층적 소프트맥스(Hierarchical Softmax, HS)란? 기존 softmax의 계산량을 현격히 줄인, softmax에 근사시키는 방법론이다. Word2Vec에서 skip-gram방법으로 모델을 훈련시킬 때 네거티브 샘플링(negative sampling) 방법과 함께 쓰인다. 어떤 건지 알아보자. 내용은 유튜브 ChrisMcCormicAI 채널의 설명을 참조했다. 기존 소프트맥스를 Word2Vec에 적용할 때의 문제점 우리가 아는 일반적인 softmax 함수를 MNIST와 같은 간단한 데이터셋에 적용할 때는 문제가 없었다. MNIST는 주어진 그림을 0부터 9까지 분류하는 문제였으므로 output이 10개면 충분했다. 하지만 Word2Vec 훈련 시에는 output의 개수가 Vocabulary..
구매하기까지 써본 헤드폰으로는 크리에이티브 오르바나 라이브 베이어다이나믹 DT770 pro 32옴 Koss KSC75 로 그렇게 많지 않다. 연구실에서 쓸 거라서 패시브 노이즈캔슬링이 필요했고 그래서 밀폐형 중에 열심히 알아봤다. HD569, K371과 고민하다가 K361로 결정했다. HD569는 호불호가 많이 갈리는 소리라는 리뷰가 꽤 많았고, K371보다도 K361이 더 괜찮았다는 리뷰가 있어서,,, 그리고 5만원정도 더 싸서 고르게 되었다. K361은 블루투스 모델과 유선 모델이 있는데 이것도 5만원정도 싸고 유선모델이 가벼우니까 착용감이 더 좋을 거라고 생각해서 유선으로 골랐다. 블루투스 모델이었으면 배터리에 조금이라도 신경을 써야 한다는 점이 거슬릴 것 같아서 유선이 오히려 좋았다. 소리 해상력..
1.1+0.1과 1.1+0.2의 차이 사진은 파이썬 콘솔에서 실행한 모습이지만, 파이썬이 아닌 대부분의 프로그래밍 언어에서 비슷한 결과를 보인다. 이 문제의 원인은 컴퓨터 프로그래밍을 맨 처음 배울 때 알게 될 정도로 많은 사람들이 알고 있을 것이다. 원인은 컴퓨터가 소수를 저장하는 방식에 있다. 컴퓨터는 이진수의 부동소수점 방식으로 소수를 저장하기 때문에 우리가 쓰는 십진수 소수를 모두 정확히 표시할 수 없고, 어떤 값들은 근삿값으로 저장할 수밖에 없다. 하지만 사진처럼 어떤 연산은 정확히 나오고, 어떤 연산은 기대하지 않은 결과를 출력하는 모습을 보인다. 그래서 1.1+0.1==1.2은 False이고, 1.1+0.2==1.3은 True가 나오는 과정을 컴퓨터처럼 비트 단위로 계산해보면서 원인을 알아보..
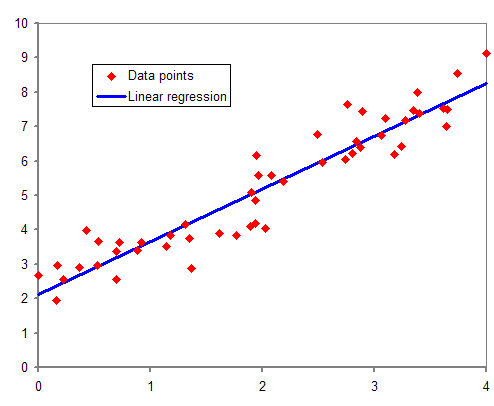
이 글에서는 로지스틱 함수를 일반화하여 소프트맥스 함수를 유도하는 과정을 살펴봅니다. 읽기 전에 선형 회귀, 로지스틱 회귀와 소프트맥스 함수의 활용에 대해 알아야 합니다. 선형 회귀를 분류에 적용하기 우리가 아는 일반적인 선형 회귀는 다음 그림이다. 이는 독립변수가 하나일 때의 모형이다. 독립변수가 여러 개일 때의 multiple linear regression의 식은 다음과 같다. $$ \large{y={\beta}_0+{\beta}_1x_1+...+{\beta}_nx_n} $$ 이를 분류(classification)에 활용하기 위해, 간단히 \(y\)를 \(p\)로 바꿔보자. $$ \large{p={\beta}_0+{\beta}_1x_1+...+{\beta}_nx_n} $$ 이 식의 문제점은 \(p\..
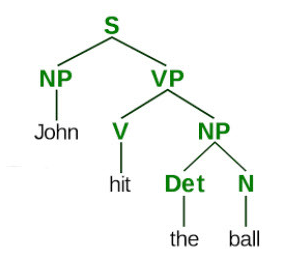
이번 장에서는 구문 분석의 대략적인 분류와 이론을 다룬다. A. 구구조 구문 분석 - 규칙 기반 - 통계 기반 - 딥러닝 기반 B. 의존 구조 구문 분석 - 구구조 구문 분석과의 차이 - 의존의 종류 - 분석 방법 C. 중의성 구구조 구문 분석 구구조란 문장의 요소들이 서로 짝을 지어 구와 절을 이룸으로써 형성되는 구조이다. 분석 방법으로는 규칙 기반, 통계 기반, 딥러닝 기반 분석이 있다. 규칙 기반 구구조 구문 분석 S → NP VP VP → V NP NP → DT NP S는 Sentence, NP는 Noun Phrase, VP는 Verb Phrase, DT는 Determiner를 의미한다. 이 문법 규칙을 'John hit the ball.'이라는 문장에 적용하면 위의 그림과 같은 분석 트리를 얻을..